Контент існував. Системи навколо нього – ні
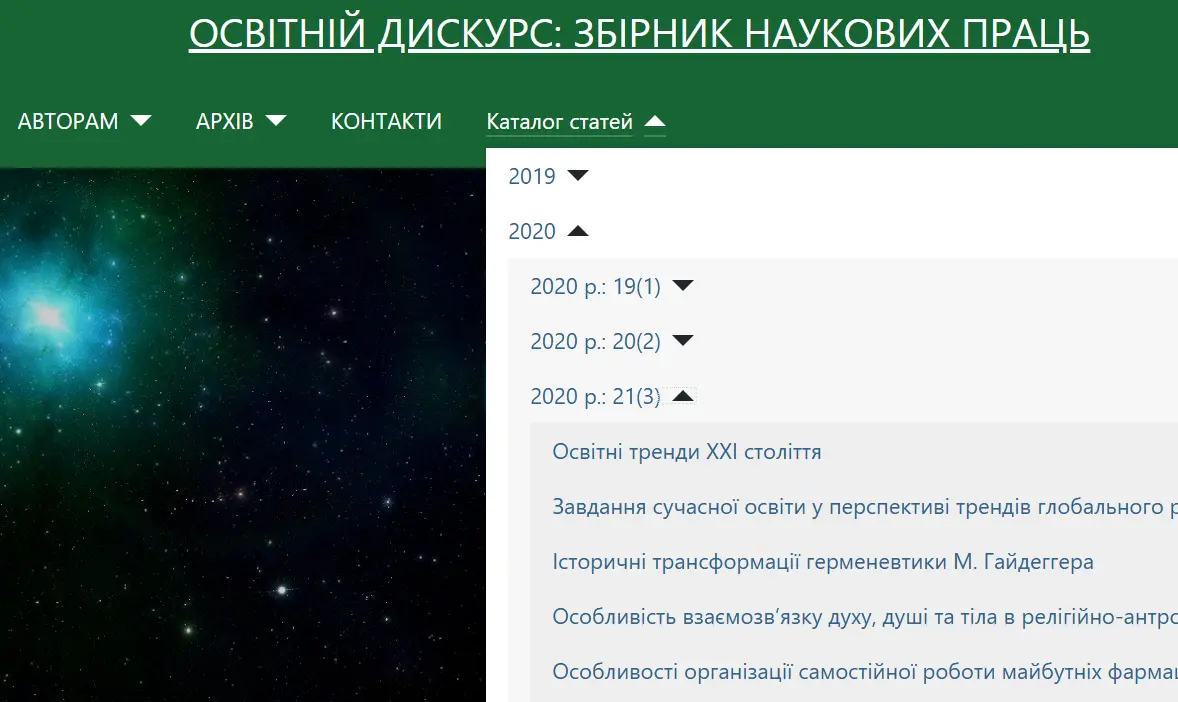
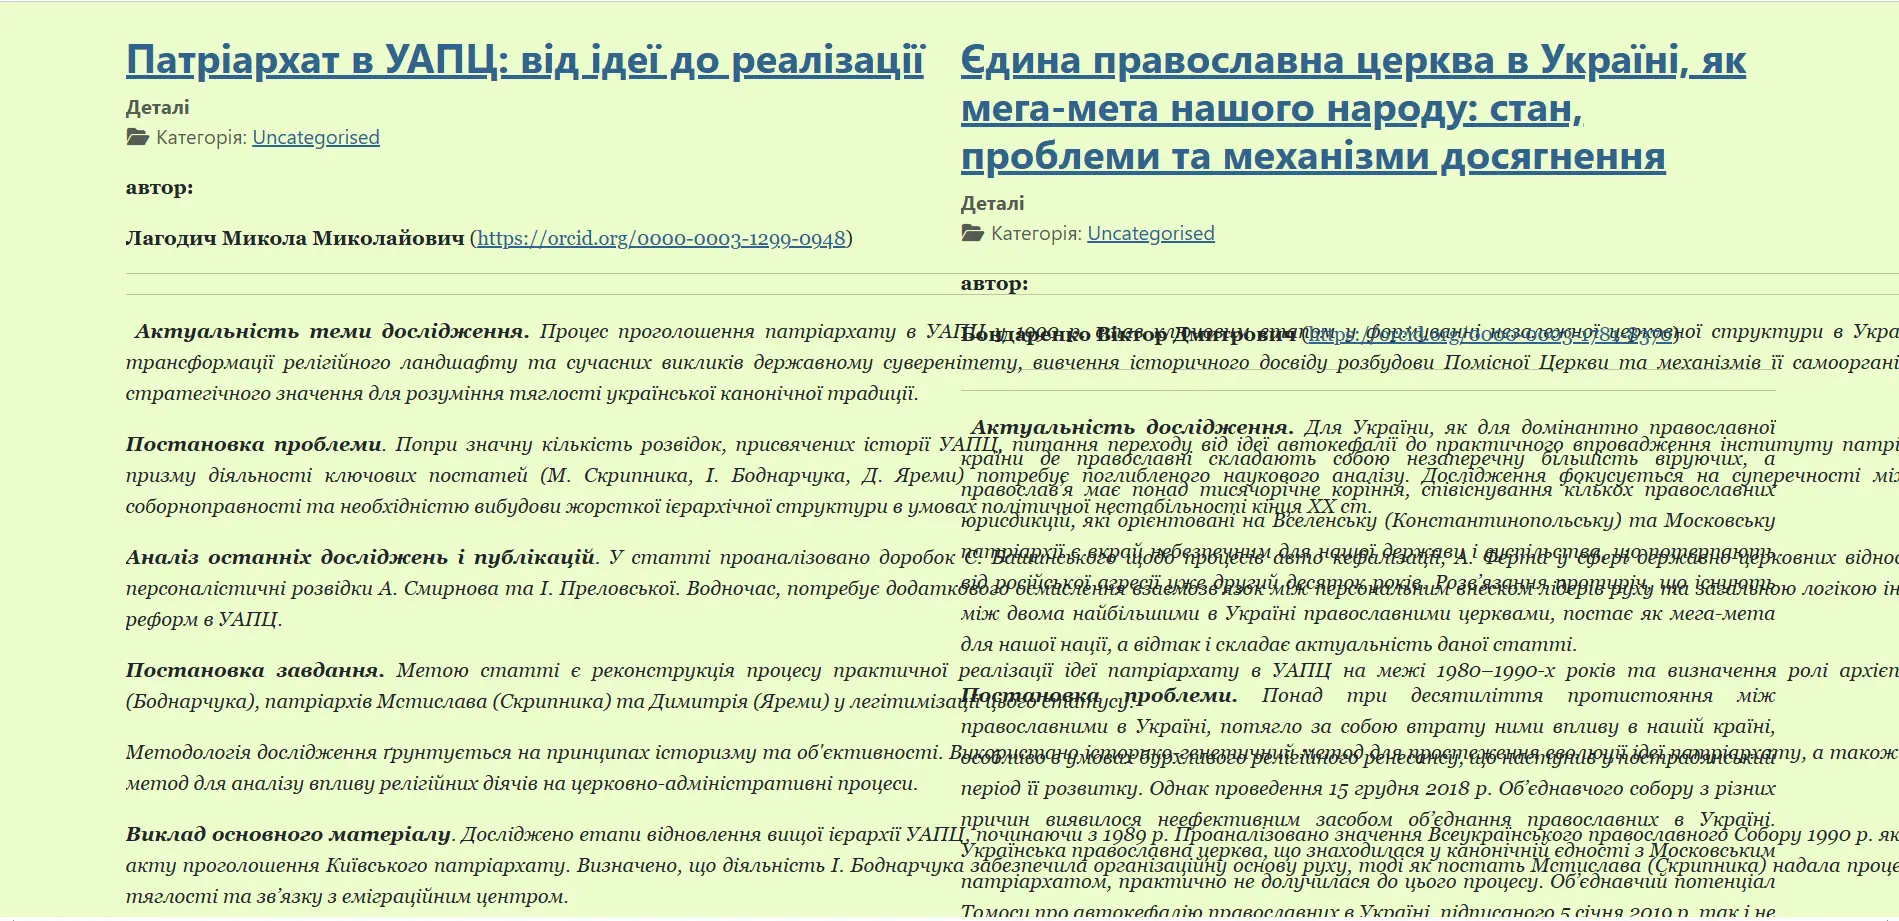
Старий сайт неможливо було перенести як набір сторінок. Протягом років дані про публікації додавалися непослідовно, без єдиної структури.
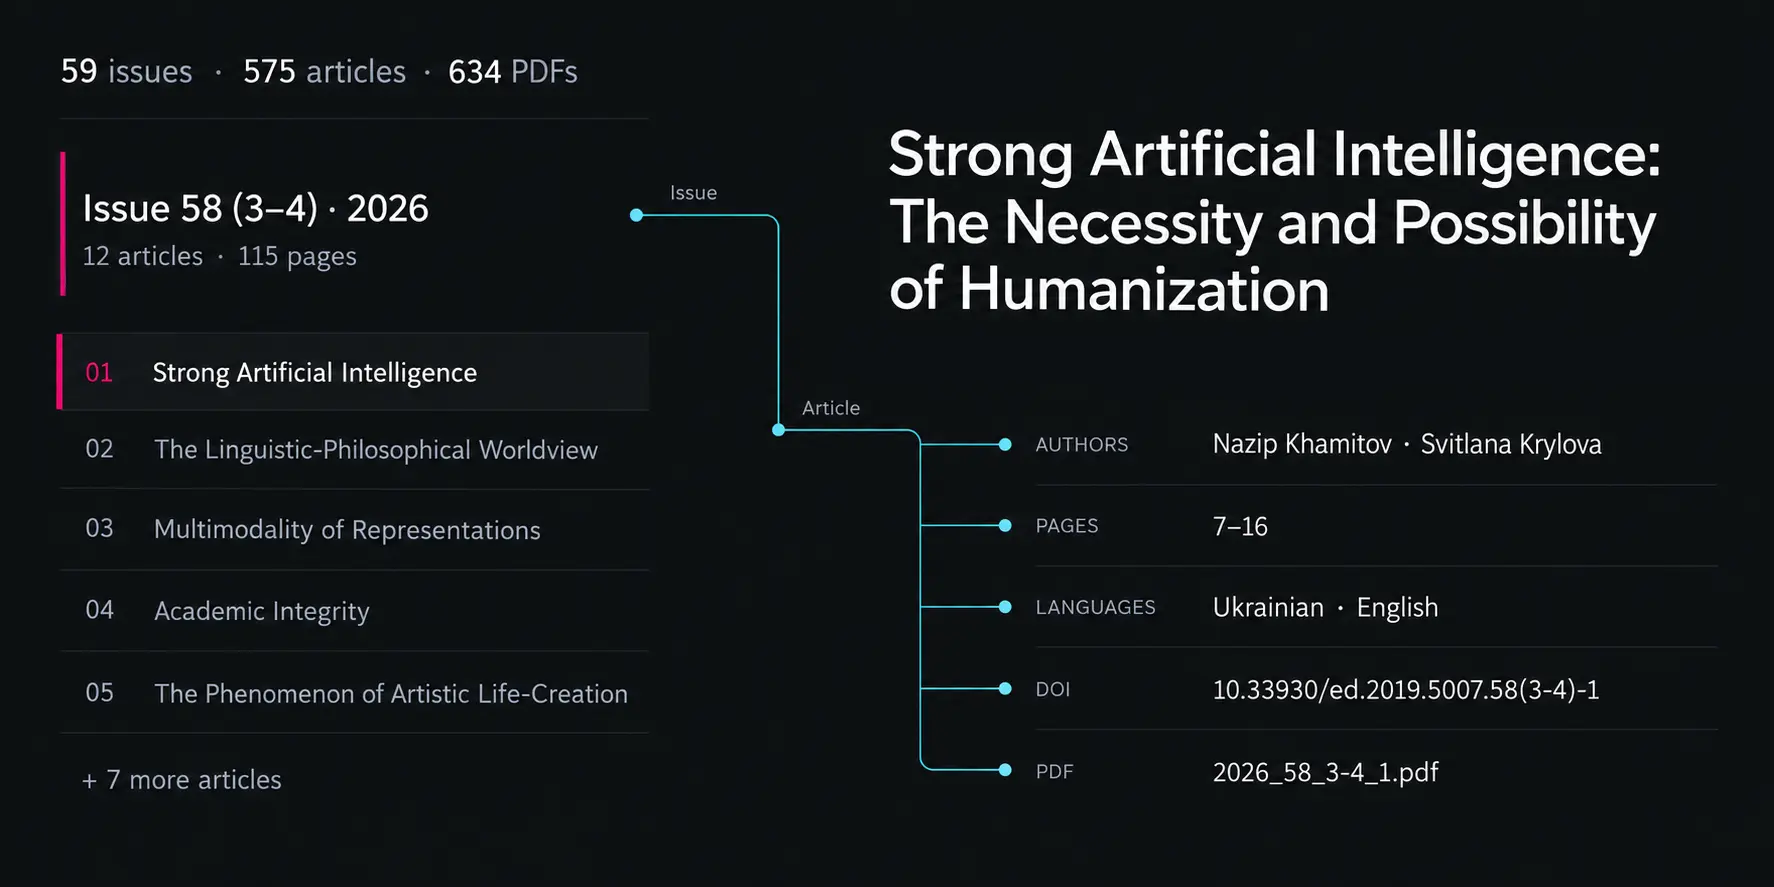
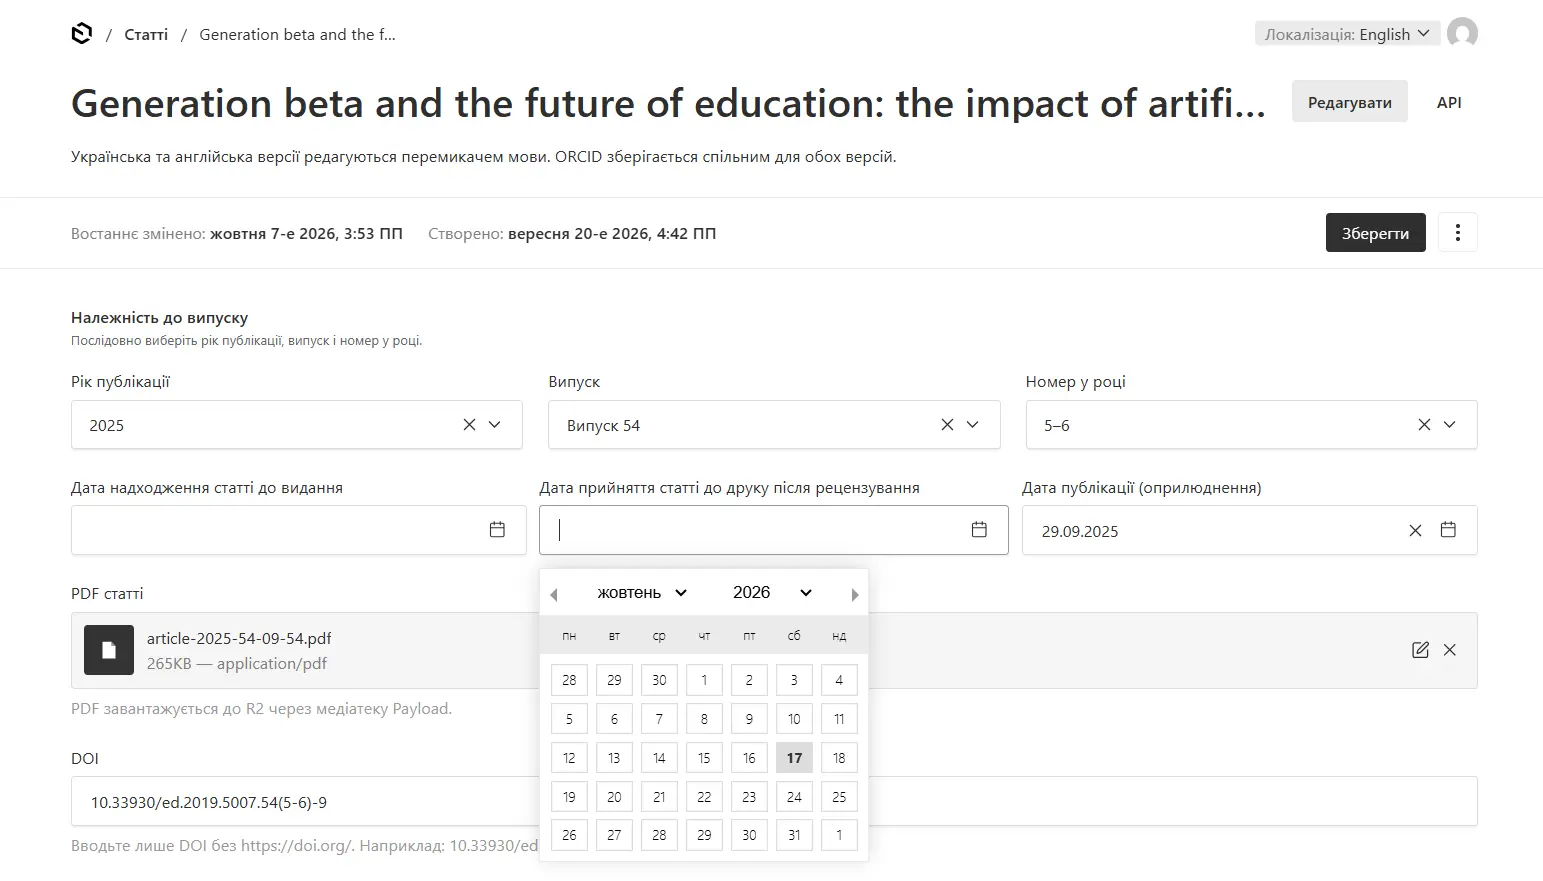
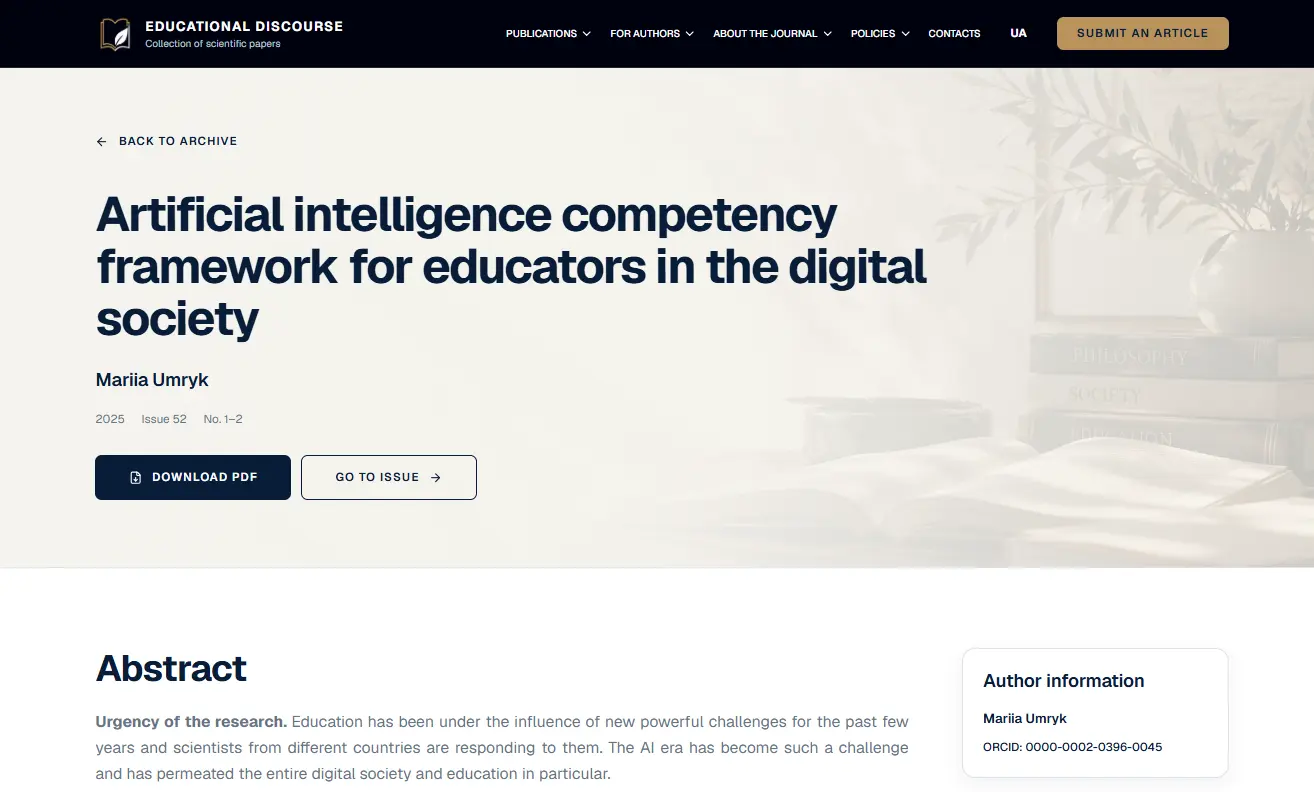
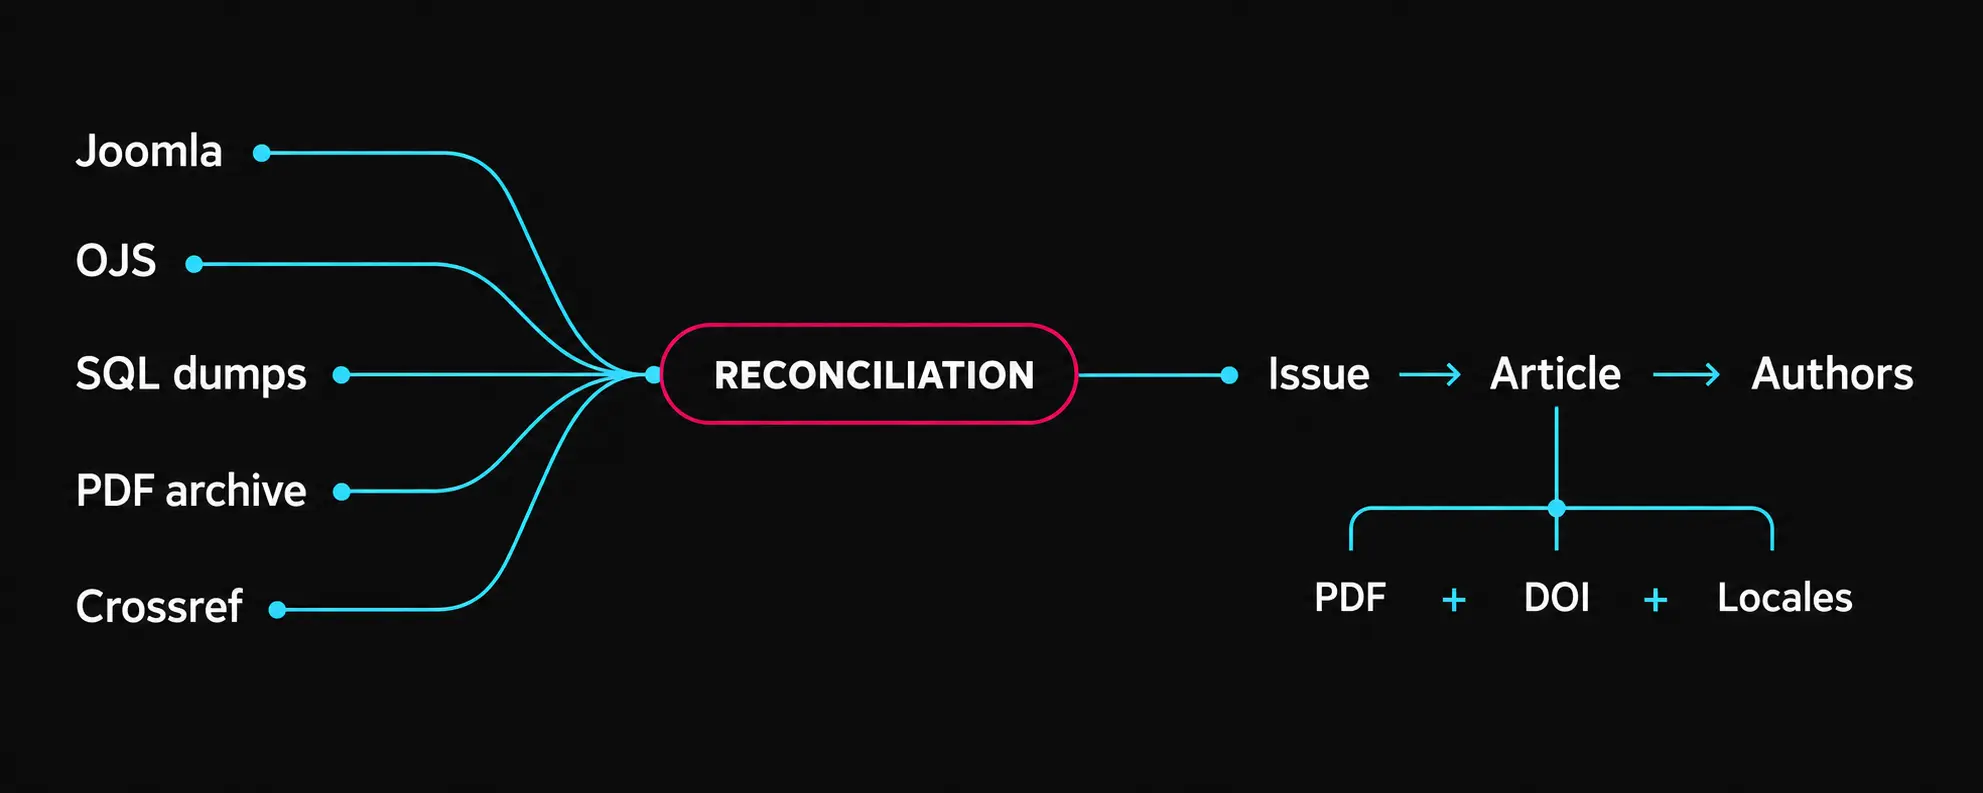
Ми реконструювали архів, звіряючи кожен випуск і кожну статтю з базами даних, PDF-файлами, файлами на сервері та записами Crossref, виявили й заповнили пропущені записи та поля й відновили правильні зв’язки.
- Відсутня узгоджена структура випусків
- Різні принципи найменування
- Статті не пов’язані з випусками
- Файли зберігаються окремо від метаданих
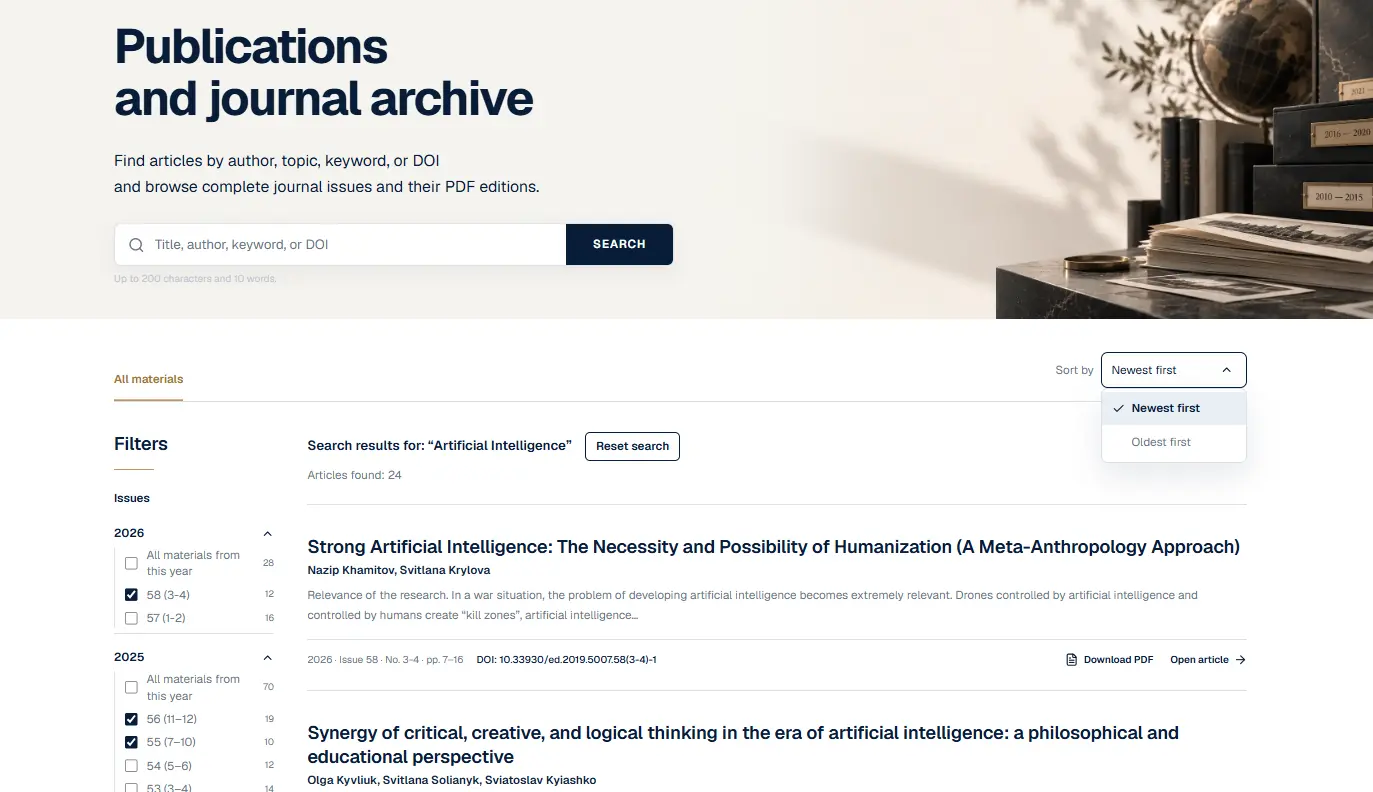
- Відсутній надійний пошук в архіві
- Застарілі URL-адреси в зовнішніх записах
Ця робота перетворила роз’єднані вихідні матеріали на цілісну модель публікацій.